Une boutique en ligne entraîne un modèle pour prédire quels visiteurs vont acheter. En janvier, il est excellent. En décembre, il est médiocre.
Personne n’a touché au code. Ce sont les clients qui ont changé. Les goûts ont évolué, les prix ont bougé, un concurrent est arrivé, une nouvelle application a changé la façon d’acheter.
En machine learning classique, on appelle cela la dérive (drift). Le modèle a appris une relation entre des entrées et des résultats au moment de l’entraînement, et le monde a bougé depuis :
On avait aussi une réponse de routine : collecter ce qui vient de se passer, réentraîner, redéployer. En symboles, chaque cycle prend les anciens poids et un nouveau lot de données , et les ajuste :
Un modèle n’était jamais une chose terminée. C’était une boucle.
C’est cette boucle qui a gardé le machine learning utile en production. Le premier modèle était rarement l’essentiel. L’essentiel, c’était que la dixième version sache sur vos clients des choses que personne n’avait jamais écrites.
Regardez un modèle se périmer
Voici un petit modèle bien réel, une régression logistique, . Il a appris à séparer les clients qui achètent de ceux qui n’achètent pas. Laissez passer le temps et regardez ce qui arrive quand il cesse d’apprendre.
Trois expériences, quelques secondes chacune. Faites-les dans l’ordre :
- Appuyez sur « Laisser passer le temps » et ne touchez à rien d’autre. Regardez les deux lignes dans le cercle, et le score à côté.
- Appuyez sur « Pause » vers le mois 12, puis sur « Réentraîner sur les données du mois ». Regardez ce que fait la ligne pleine.
- Appuyez sur « Recommencer », cochez « Réentraîner chaque mois », puis appuyez de nouveau sur « Laisser passer le temps ». Comparez les deux courbes du graphique.
Interactif · un vrai modèle, un monde jouet
Le monde bouge. Et le modèle ?
Chaque point est un client. Le modèle a tracé une ligne pour séparer ceux qui achètent de ceux qui n’achètent pas, et il avait raison 96 % du temps. Laissez maintenant passer le temps.
1 · Regardez les comportements dériver
Les clients ne bougent pas. Ce qu’ils font change un peu chaque mois. La ligne du modèle ne bouge que si vous le réentraînez.
- AchèteN’achète pas
- Le modèle se trompe sur celui-ci
- Là où le modèle trace la ligne
- Là où la ligne se trouve vraiment aujourd’hui
2 · Tenez le score
Mois 0 sur 18
- Juste ce mois-ci
- 96 %
- Jamais réentraîné
- 96 %
- Réentraînements
- 0
Votre modèleJamais réentraîné
Mois 0. Le modèle a été entraîné sur les clients d’aujourd’hui : les deux lignes coïncident.
Le monde est un jouet : deux variables, et des comportements qui tournent de 5 degrés par mois. Le modèle est réel : une régression logistique, entraînée dans votre navigateur par descente de gradient sur 400 clients et évaluée sur les 200 que vous voyez, qu’elle n’a jamais vus à l’entraînement.
Ce que vous avez dû voir :
- Laissé à lui-même, le modèle se dégrade. Il part de 96 %. Au bout d’un an, il est à 68 %. Au bout de 18 mois, à 52 % : pour une question à deux réponses, c’est pile ou face. Pas une ligne de code n’a changé.
- Un seul réentraînement le ramène. Au mois 12, il passe de 68 % à 94 % en une étape. Le réentraînement n’a pas ajouté de règle. Il a déplacé les poids là où sont les clients aujourd’hui.
- Réentraîné chaque mois, il tient. Le modèle a toujours un mois de retard, et il ne descend jamais sous 90 %.
Gardez cette image en tête. Regardez maintenant comment on déploie les LLM.
Deux mémoires
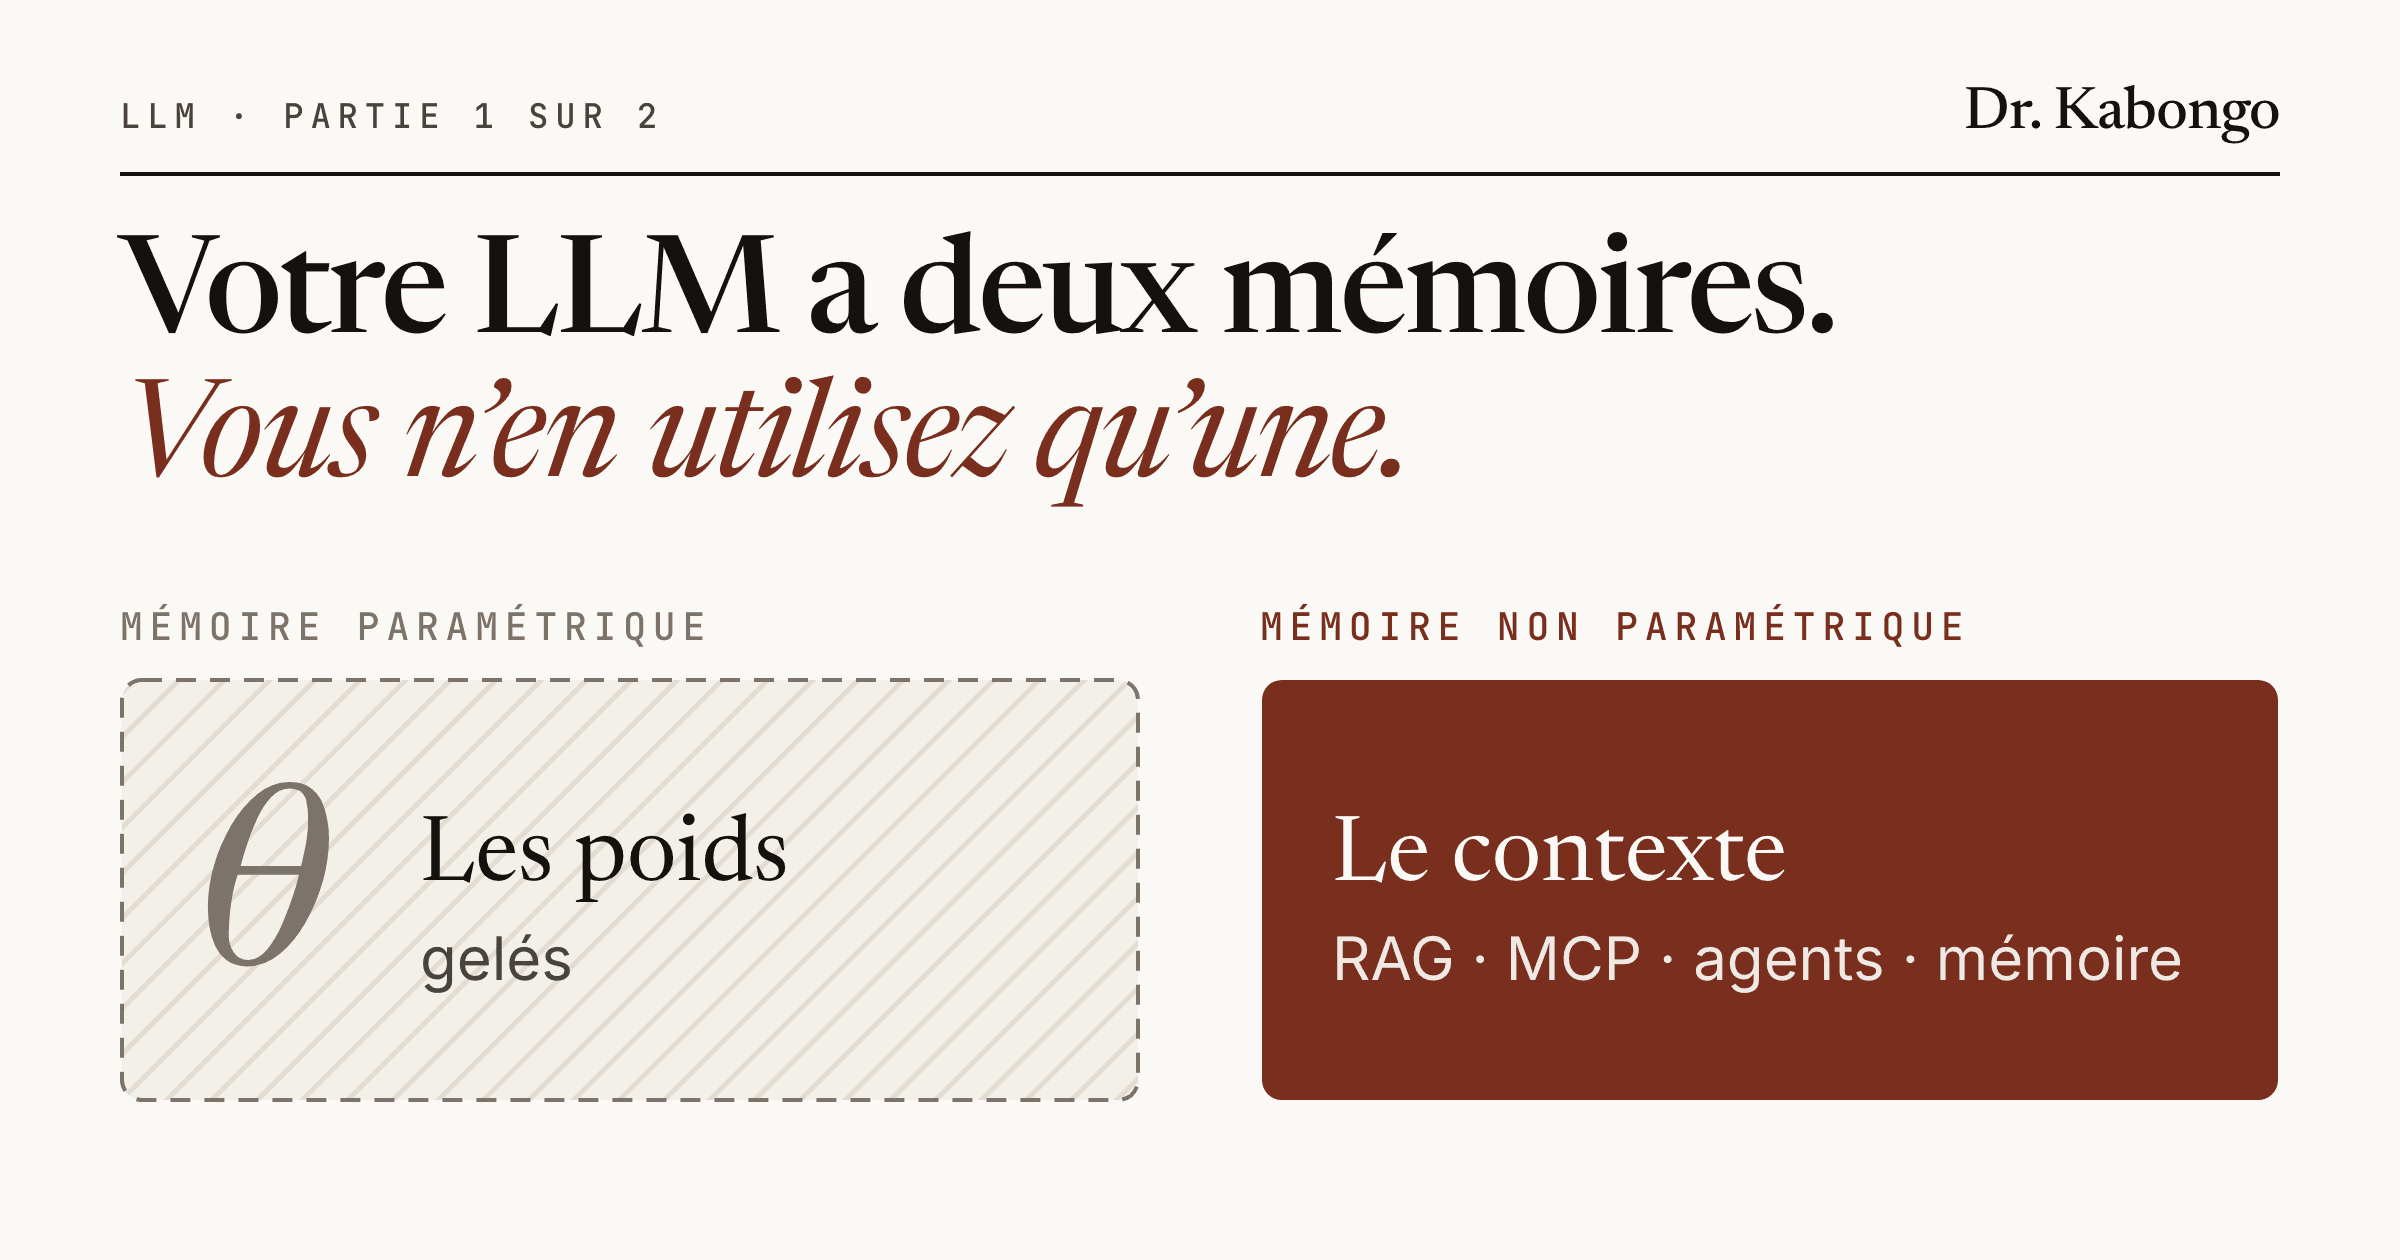
En 2020, Patrick Lewis et ses collègues ont publié l’article qui nous a donné le mot RAG : Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Il nous a aussi donné deux expressions très utiles. Un tel système a deux mémoires :
- La mémoire paramétrique : ce qui est stocké dans les poids du modèle. C’est l’entraînement qui l’y a mis.
- La mémoire non paramétrique : ce qui est stocké hors des poids et consulté au besoin. Dans l’article, c’était un index de Wikipédia dans lequel on peut chercher.
Une ligne de notation rend la différence exacte. Un LLM produit une réponse à partir d’une distribution :
Il n’y a que deux choses qu’on puisse changer dans cette expression. Les poids, . Et le contexte, tout ce qui se trouve à droite de la barre. J’appellerai « non paramétrique » tout ce côté droit, ce qui est un peu plus large que l’usage de l’article.
Ce que l’article RAG entraînait vraiment
Un détail de cet article s’oublie facilement. Les auteurs ont entraîné les deux côtés.
Leur système avait deux parties. Un moteur de recherche (retriever) notait 21 millions de passages de Wikipédia par rapport à la question . Un générateur écrivait la réponse à partir des passages reçus. Le passage retrouvé était traité comme une variable cachée, et l’ensemble était entraîné sur un seul objectif :
Lisez-le ainsi. La probabilité de la bonne réponse est une somme sur les passages retrouvés, chacun pondéré par le score que lui donne le moteur de recherche. L’entraînement fait monter cette probabilité, et l’erreur revient donc dans les deux termes :
- Le générateur apprend à lire ce qu’on lui retrouve. Il s’exerce à écrire des réponses à partir des passages que ce moteur renvoie réellement, les bons comme les mauvais.
- Le moteur de recherche apprend ce que « utile » veut dire. Si un passage a aidé à produire la bonne réponse, son score monte la fois suivante. Personne n’a eu à étiqueter le bon passage. Le succès du générateur servait d’étiquette.
Cela comptait. Quand les auteurs ont gelé le moteur de recherche et entraîné seulement le générateur, la précision exacte sur Natural Questions est tombée de 43,5 à 37,8.
Ils n’ont pourtant pas tout entraîné. L’encodeur de documents et l’index sont restés fixes, car réencoder 21 millions de passages après chaque mise à jour coûtait trop cher. Et ils ont montré ce qu’apporte un index fixe et remplaçable : en échangeant un index Wikipédia de 2016 contre celui de 2018, les réponses du modèle sur les dirigeants mondiaux ont suivi l’index. Environ 70 % de bonnes réponses avec la bonne année, 12 % ou moins avec la mauvaise. Sans réentraînement.
Le RAG d’origine contenait donc deux idées, pas une :
- Changer l’index pour changer ce que le modèle sait.
- Entraîner les deux parties ensemble pour que chacune apprenne à travailler avec l’autre.
Ce que le RAG d’aujourd’hui a gardé, et ce qu’il a abandonné
Le RAG d’aujourd’hui a gardé la première idée et abandonné la seconde. Un pipeline typique, c’est un modèle d’embeddings généraliste, une base vectorielle, un LLM gelé, et du code pour les relier. Rien n’y a été entraîné sur votre tâche.
Il y avait de bonnes raisons à cela, et je ne veux pas prétendre le contraire :
- Les modèles ont appris à lire. En 2020, il fallait affiner le générateur pour qu’il sache seulement utiliser un passage. Un LLM moderne utilise un passage collé sans aucun entraînement. Ce seul changement a fait paraître l’entraînement facultatif.
- On ne fait pas passer un gradient par une API. Avec un modèle fermé, il n’y a rien dans quoi rétropropager.
- Des parties séparées se remplacent facilement. Nouveau modèle, nouvel index, nouveaux embeddings : chacun peut changer sans toucher aux autres.
- Des ingénieurs peuvent le construire en une semaine. Pas de données d’entraînement, pas de GPU, pas de courbes de perte.
Mais voici ce qui a été abandonné avec l’entraînement :
- Un moteur de recherche qui connaît votre tâche. Un embedding généraliste classe les passages selon « proche du sens de la question ». Le moteur entraîné les classait selon « a aidé à produire la bonne réponse ». Ce n’est pas la même chose. Les rerankers, la recherche hybride et la réécriture de requêtes sont autant de rustines sur cet écart.
- Un générateur qui connaît votre moteur de recherche. Un LLM gelé ne s’est jamais exercé sur ce que votre moteur renvoie. Il ne sait pas à quelle fréquence le premier passage est faux, ni quand l’ignorer. RAFT entraîne exactement cela : ignorer les passages qui n’aident pas, et citer celui qui aide.
- La boucle. Dans l’article, chaque exemple d’entraînement améliorait les deux parties. Dans un pipeline gelé, une mauvaise réponse n’améliore rien, sauf si un ingénieur lit le journal et modifie un prompt. C’est de nouveau la démo sur la dérive : le système a cessé d’apprendre de ses propres résultats.
Et le gain est toujours là pour ceux qui entraînent. RA-DIT a affiné le modèle de langage pour qu’il exploite le texte retrouvé, puis le moteur de recherche pour qu’il renvoie ce que le modèle préfère, et a dépassé les approches de recherche en contexte de jusqu’à 8,9 points en moyenne, sans exemple dans le prompt. REPLUG est le résultat que je trouve le plus pratique : il traite le modèle de langage comme une boîte noire, n’entraîne que le moteur de recherche à partir des retours du modèle, et a tout de même amélioré GPT-3 de 6,3 %. Même avec un modèle fermé, la moitié de la boucle vous est ouverte.
C’est tout l’argument de cette série en deux parties, en miniature. À l’intérieur même du RAG, la conception d’origine contenait de l’apprentissage. Nous avons gardé la tuyauterie et abandonné l’apprentissage.
Enlevez les noms
RAG. GraphRAG. Agents. Outils. MCP. Skills. « Mémoire ». Ingénierie de contexte.
Chacun de ces termes recouvre un vrai travail d’ingénierie, et j’en utilise la plupart. Mais enlevez les noms et regardez ce qui arrive au modèle. Tous finissent de la même façon : en tokens placés dans la fenêtre de contexte.
- Le RAG trouve des passages de texte et les colle dedans.
- GraphRAG parcourt un graphe de connaissances, puis écrit sous forme de texte les faits trouvés et les colle dedans.
- Un appel d’outil ou un serveur MCP exécute quelque chose, et son résultat est collé dedans sous forme de texte.
- Une fonction de « mémoire » enregistre des notes, et en recolle quelques-unes la fois suivante.
Puis le modèle fait la seule chose qu’il sait faire : prédire le token suivant sachant tout cela. (J’ai décrit ce mécanisme dans Les LLM sont des machines à probabilités conditionnelles.)
Remarquez ce qu’on n’obtient jamais : une garantie. Nous choisissons ce qui va à droite de la barre. Nous ne choisissons pas la façon dont le modèle s’en sert. Il peut s’appuyer sur le passage, l’ignorer, ou le mélanger à un souvenir approximatif de son entraînement.
Et dans chacune de ces techniques, ne bouge pas.
Comment on en est arrivé là
Aujourd’hui, la plupart des équipes gèlent une mémoire et travaillent entièrement dans l’autre.
Les chiffres le confirment. Dans l’enquête 2024 de Menlo Ventures auprès de 600 responsables informatiques d’entreprise, l’adoption du RAG atteignait 51 %, et seuls 9 % des modèles en production étaient affinés (fine-tuned). Leur enquête 2025 qualifie le fine-tuning de pratique « encore de niche », et voit les modèles open source passer de 19 % à 11 % de l’usage en entreprise.
Je pense que la raison tient surtout aux personnes, pas à ce qui marche le mieux.
Il y a bien plus d’ingénieurs logiciels que de chercheurs en machine learning. Une estimation souvent reprise, datant de 2023, parlait d’environ 5 000 chercheurs en LLM dans le monde pour environ 50 millions d’ingénieurs logiciels. Le chiffre est approximatif, mais c’est la proportion qui compte. Changer le contexte est un travail d’ingénieur : un appel d’API, une base de données, un pipeline. Changer les poids est un travail de machine learning : des données, des courbes de perte, de l’évaluation. Les progrès des trois dernières années se sont faits là où étaient les gens.
Ce n’est pas une critique. Cette ingénierie est remarquable. Mais cela veut dire que le côté contexte a reçu presque tout l’effort, et le côté poids presque rien. Quand on a tiré aussi fort et aussi longtemps sur l’un des deux leviers, le prochain grand gain a plus de chances de venir de l’autre.
Pendant ce temps, la porte des poids se referme. En mai 2026, OpenAI a commencé à fermer sa plateforme de fine-tuning en libre-service : plus de nouveaux clients, et plus aucun nouvel entraînement pour personne après le 6 janvier 2027. L’API Gemini de Google ne propose plus de modèle ajustable.
Comparez avec la démo ci-dessus. En ML classique, ce que l’entreprise apprenait revenait dans les poids. Dans la plupart des systèmes à base de LLM, cela n’a nulle part où aller, sauf dans le prompt.
Un expert brillant avec un classeur
Voici l’image que je trouve la plus juste.
Vous embauchez un expert brillant. Il a presque tout lu. Il a aussi une particularité étrange : il ne peut pas former de nouveaux souvenirs. Chaque matin, il se réveille en sachant exactement ce qu’il savait le premier jour.
Alors vous lui donnez un classeur. Avant chaque tâche, il lit les pages utiles : vos prix, vos politiques, vos procédures, les notes de l’incident de la semaine dernière. Il lit vite et il est très bon, donc cela marche étonnamment bien.
Puis l’entreprise grandit et change, et trois choses se produisent :
- Le classeur s’épaissit, et il le relit pour chaque tâche. Vous payez cette lecture à chaque fois.
- Quelqu’un doit trouver les bonnes pages. Si on lui sort les mauvaises, l’expert travaille avec assurance à partir des mauvaises pages.
- Certaines leçons ne tiennent pas sur une page. « Répondez comme notre meilleur agent. » « Reconnaissez le client qui est sur le point de partir. » On ne peut pas écrire cela. Les gens l’apprennent sur des centaines de cas.
Ce dernier point est le cœur du sujet. Le contexte contient ce qu’on peut écrire. Les poids contiennent ce qu’on ne peut que montrer par l’exemple.
(J’avais d’abord imaginé une tarte dont une moitié serait gelée. Mais les parts d’une tarte sont les parts d’un tout fixe, et ces deux mémoires ne sont les parts de rien. Elles contiennent des choses de nature différente, et elles se multiplient l’une l’autre.)
La leçon des GPT personnalisés
Nous avons déjà fait cette expérience à très grande échelle.
Fin 2023, OpenAI a permis à chacun de créer un « GPT personnalisé », et en janvier 2024 a ouvert une boutique pour eux. L’idée : un assistant spécialisé pour chaque métier, le GPT fiscal, le GPT juridique, le GPT cuisine. Beaucoup s’attendaient à ce qu’ils détournent les utilisateurs du ChatGPT ordinaire.
Cela ne s’est pas produit. Et OpenAI retire maintenant les GPT personnalisés, avec un arrêt prévu courant décembre 2026.
Regardez de quoi un GPT personnalisé était fait : des instructions écrites, quelques fichiers importés, et des connexions à des services externes. C’était un classeur, et rien d’autre. Le modèle en dessous était le même ChatGPT que tout le monde avait déjà.
Y avait-il un entraînement discret en coulisses, un petit adaptateur par GPT ? OpenAI n’a pas publié les détails internes, je ne peux donc pas prouver une absence. Mais tout ce qui est visible dit non :
- Un GPT personnalisé était prêt dès qu’on l’enregistrait. Même un petit fine-tuning demande une préparation des données et du temps de GPU.
- Son créateur pouvait changer le modèle de base sur lequel il tournait. Des poids entraînés sont liés à un modèle. Un jeu d’instructions ne l’est pas.
- Les fichiers importés étaient conservés et consultés au moment de répondre. Les pages d’aide d’OpenAI les décrivent comme des documents de référence : une partie est placée dans la fenêtre de contexte, le reste va dans un index de recherche. Si le modèle avait appris les fichiers, il n’y aurait rien à chercher.
- Les fichiers pouvaient être extraits mot pour mot. Cela ne marche que s’ils sont là, sous forme de texte.
- Quand les GPT personnalisés ont été migrés, ce sont les instructions et les fichiers qui ont été déplacés. Il n’y avait pas de poids à déplacer.
C’est aussi pour cela que les créateurs devaient importer des documents. Sans entraînement, la seule façon pour vos connaissances d’atteindre le modèle est d’être relues, à chaque question.
Vu ainsi, trois choses en découlent :
- Il n’apprenait jamais. Après dix mille conversations, un GPT personnalisé savait exactement ce qu’il savait après la première. Aucune correction, aucun résultat, aucune habitude d’usage ne revenait en lui.
- Il était facile à copier. Si toute votre expertise est du texte dans un prompt, elle peut être lue. Des chercheurs ont testé plus de 200 GPT personnalisés et ont pu en extraire à la fois les instructions cachées et les fichiers importés.
- Il n’y avait rien pour remplacer ChatGPT. Chaque GPT personnalisé était ChatGPT, avec une note épinglée. Chaque fois que le modèle de base progressait, la note comptait moins.
La leçon que j’en tire est plus étroite, et je pense qu’elle tient : un spécialiste qui ne diffère du généraliste que par son contexte n’est pas un autre modèle. C’est le même modèle, qui lit une note.
Alors, que fait-on ?
D’abord, ce que cela ne veut pas dire. Le RAG n’est pas une erreur. Pour les faits qui changent, la recherche documentaire est le bon outil, et les preuves en ce sens sont solides. Je le montrerai dans la partie 2.
Le problème est plus étroit. Nous avons pris une technologie qui apprend, et nous l’avons déployée de façon qu’elle ne fasse que lire :
- La démo sur la dérive : un modèle qui cesse d’apprendre se périme, aussi bon qu’il ait été le premier jour.
- L’article RAG : la conception d’origine entraînait les deux mémoires. Nous avons gardé la moitié qui ne demande aucun entraînement.
- Les GPT personnalisés : un spécialiste fait uniquement de contexte, c’est le généraliste qui lit une note.
Nous avons construit des systèmes qui lisent.
Nous avons cessé de construire des systèmes qui apprennent.
Dans la partie 2, « Au-delà de la fenêtre de contexte : apprendre votre métier au modèle », je regarde jusqu’où la fenêtre de contexte peut vraiment aller, ce qu’est l’empoisonnement du contexte et pourquoi il est si difficile à corriger, puis je passe à la pratique : quelles leçons vont dans le contexte et lesquelles dans les poids (avec une seconde démo), pourquoi vos propres données sont la seule chose qu’un concurrent ne peut pas copier, ce que coûte vraiment le fine-tuning efficace, et pourquoi je pense que la prochaine étape passe par les modèles ouverts.
Avant de partir : où finit aujourd’hui ce que votre équipe apprend ? Dans un prompt, dans un modèle, ou nulle part ? Dites-le-moi dans les commentaires.
Commentaires
Chargement des commentaires…